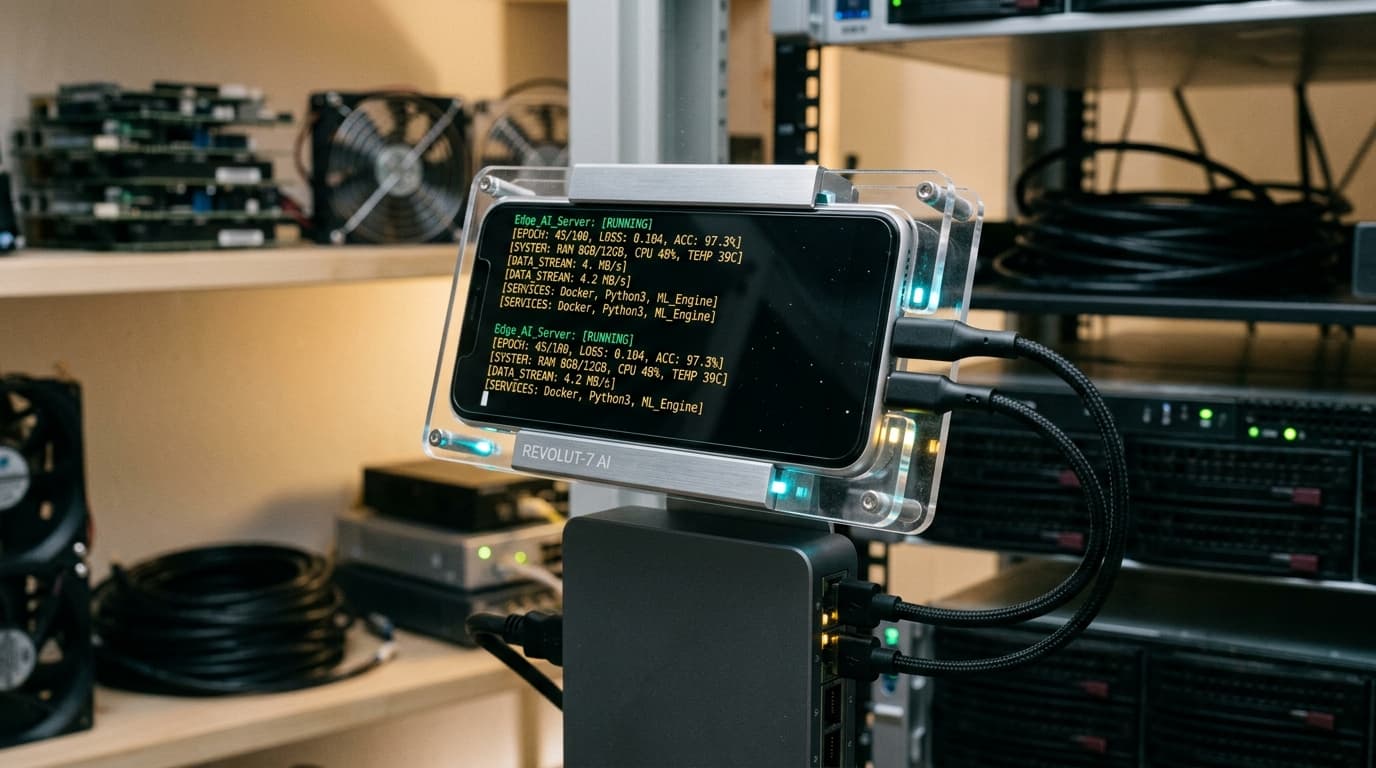
A busca por inferência de IA local e privada cresceu vertiginosamente. Manter dados confidenciais sob controle estrito, evitar custos abusivos de tokens em APIs de nuvem e ter respostas instantâneas são prioridades para desenvolvedores e empresas focadas em segurança de dados.
No entanto, comprar hardware de ponta ou GPUs corporativas dedicadas exige investimentos pesados. Uma das soluções mais engenhosas e econômicas é olhar para a gaveta de eletrônicos antigos: smartphones topo de linha de gerações passadas (equipados com chips Qualcomm Snapdragon 845, 855 ou 870) continuam sendo computadores poderosos de 64 bits.
Neste artigo, você aprenderá como transformar um smartphone antigo em um servidor de IA de borda (Edge AI Node) rodando postmarketOS (Alpine Linux) e Ollama.
1. As Vantagens do Hardware de Smartphone para Servidores Domésticos
Ao comparar um smartphone reaproveitado com placas de desenvolvimento comuns (como o Raspberry Pi 4), o celular oferece vantagens únicas de fábrica:
- Memória Rápida e Unificada: Celulares topo de linha usam módulos LPDDR4X com largura de banda superior à maioria das placas de entrada.
- Armazenamento UFS Integrado: As memórias flash UFS 2.1 ou UFS 3.1 oferecem velocidades de leitura sequencial acima de 800 MB/s, superando cartões MicroSD convencionais em quase 10 vezes.
- Nobreak Nativo (Bateria Integrada de 4000 mAh): Quedas de energia na rede pública não desligam o servidor nem corrompem o sistema de arquivos. O aparelho continua respondendo na rede local ou via Wi-Fi sem interrupções.
2. Configurando o postmarketOS em Modo Headless
Para que o celular funcione como servidor dedicado, remova a interface gráfica e configure o sistema para operar exclusivamente via linha de comando (CLI):
# 1. Mascarar alvos de suspensão de energia
sudo systemctl mask sleep.target suspend.target hibernate.target hybrid-sleep.target

# 2. Configurar boot direto para modo texto (multi-user)
sudo systemctl set-default multi-user.target
Após o reboot, o consumo de RAM do sistema operacional fica em torno de 180 MB, liberando mais de 5.5 GB de memória física para carregar modelos de linguagem.
3. Instalando o Ollama na Arquitetura ARM64
O Ollama possui suporte oficial compilado nativamente para arquiteturas Linux aarch64. A instalação é direta:
curl -fsSL https://ollama.com/install.sh | sh
Para liberar o acesso via rede local ou malha Tailscale, configure o serviço:
sudo systemctl edit ollama.service
Adicione o bloco:
[Service]
Environment="OLLAMA_HOST=0.0.0.0:11434"
Environment="OLLAMA_KEEP_ALIVE=24h"
Reinicie o daemon:
sudo systemctl daemon-reload
sudo systemctl restart ollama.service
4. Escolhendo os Melhores Modelos de Linguagem para Edge
Nos SoCs móveis, o objetivo é rodar Small Language Models (SLMs) com quantização de 4 bits:
# Qwen 2.5 Coder 1.5B (Ideal para autocompletar código e tarefas de programação)
ollama pull qwen2.5-coder:1.5b

# Llama 3.2 3B (Excelente para resumos, conversação e triagem de logs)
ollama pull llama3.2:3b
Benchmarks Reais de Inferência:
- Qwen 2.5 Coder 1.5B: ~12 a 15 tokens por segundo (latência quase imperceptível para autocompletar no VS Code via extensão Continue.dev);
- Llama 3.2 3B: ~7 a 9 tokens por segundo (velocidade de leitura humana confortável);
- Consumo de Energia: Aproximadamente 1 Watt em repouso e 3.5 Watts sob inferência contínua.
Conclusão
Reaproveitar um smartphone antigo com Linux de baixo nível é uma vitória dupla: evita o descarte prematuro de eletrônicos nobres e cria um micro-servidor de IA resiliente, privado e imune a quedas de energia.
Para projetos maiores que demandam modelos de 14B a 70B parâmetros e escalabilidade corporativa, conte com as soluções de engenharia e IA da Landingfymax. Conheça nossos serviços de ponta a ponta.